Quand les pannes informatiques désorganisent toute l’entreprise
Un ordinateur qui redémarre sans prévenir, une application métier inaccessible ou une connexion instable suffisent à ralentir plusieurs collaborateurs. Au fil des incidents, les minutes perdues s’additionnent, les demandes urgentes se multiplient et les équipes finissent par contourner les outils prévus pour travailler efficacement. La maintenance informatique en entreprise répond à ce besoin très concret en agissant avant que la panne ne bloque l’activité.
Sur le terrain, le problème vient rarement d’un seul équipement défectueux. Il résulte plutôt d’un parc hétérogène, de mises à jour repoussées, de sauvegardes jamais testées ou d’un manque de visibilité sur les incidents récurrents. Une démarche utile commence donc par l’observation des interruptions réelles, leur fréquence, leur durée et les services concernés, plutôt que par l’achat immédiat de nouveau matériel.
Cette logique de continuité concerne aussi les entreprises qui travaillent leur visibilité, leur communication et leur acquisition en ligne. Une équipe peut investir dans un site, du référencement ou des campagnes publicitaires, puis perdre en efficacité si les outils internes restent instables. Pour approfondir l’approche préventive et découvrir comment réduire les interruptions grâce à la maintenance informatique en entreprise, un article dédié présente une méthode centrée sur la disponibilité des services. Ce rapprochement est concret : dans les deux cas, il s’agit de mieux organiser les ressources et de préserver le temps consacré aux tâches qui créent de la valeur.
Ce que couvre réellement la maintenance informatique
La maintenance ne se limite pas au dépannage d’un ordinateur qui ne démarre plus. Elle englobe la surveillance, la prévention, la correction et l’amélioration progressive de l’environnement numérique. Son périmètre doit être défini avec précision afin d’éviter les zones grises lorsque survient un incident.
La maintenance préventive
Elle consiste à vérifier régulièrement l’état des postes, des serveurs, des équipements réseau et des logiciels. Le contrôle de l’espace disque, de la santé des supports de stockage, des journaux système et des versions installées permet de repérer des signaux faibles. Une machine dont le disque est presque saturé ou dont les mises à jour échouent régulièrement constitue déjà un risque, même si elle fonctionne encore.
Un calendrier simple peut suffire pour commencer. Chaque mois, l’entreprise peut examiner les alertes, les capacités de stockage et les postes les plus lents. Chaque trimestre, elle peut revoir les comptes utilisateurs, les droits d’accès, les équipements vieillissants et les résultats des sauvegardes. Cette régularité vaut mieux qu’un grand nettoyage réalisé uniquement après une panne.
La maintenance corrective
La maintenance corrective intervient lorsqu’un dysfonctionnement est constaté. La priorité consiste alors à rétablir le service, puis à rechercher la cause afin d’éviter une répétition. Un ticket correctement documenté doit préciser l’heure de début, les utilisateurs concernés, le message d’erreur, les actions déjà tentées et le moment du rétablissement.
Cette méthode permet de distinguer un incident isolé d’un problème structurel. Si cinq collaborateurs rencontrent la même coupure réseau en deux semaines, le traitement poste par poste ne suffit plus. Il faut examiner le commutateur, le câblage, la configuration ou le fournisseur d’accès, selon les éléments relevés.
La maintenance évolutive
Les besoins de l’entreprise changent avec les recrutements, le télétravail, les nouveaux logiciels et les exigences de sécurité. La maintenance évolutive accompagne ces changements en ajustant l’architecture, les règles d’accès et les outils. Elle évite que chaque évolution soit traitée dans l’urgence, avec des réglages provisoires difficiles à maintenir.
Mesurer les interruptions pour agir au bon endroit
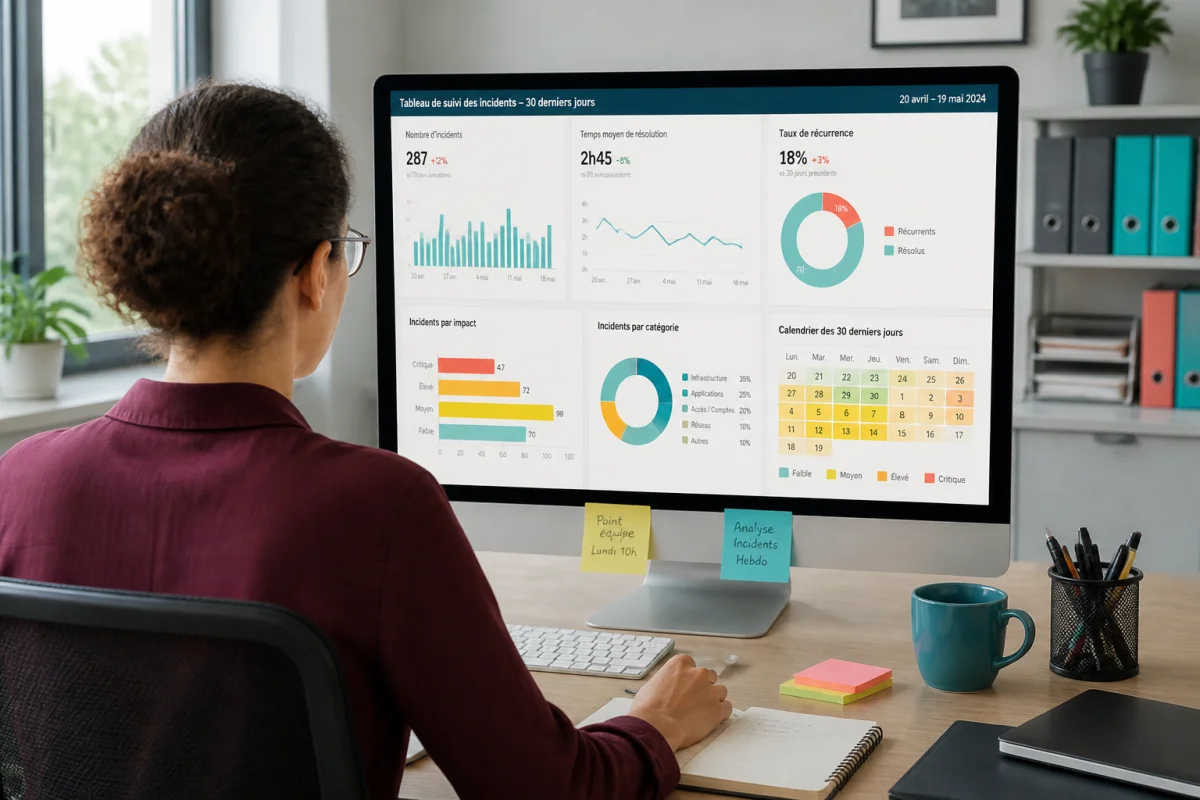
Sans mesure, les décisions reposent souvent sur l’impression de la personne qui signale le plus de problèmes. Un suivi minimal apporte déjà une vision plus fiable. Il peut comporter le nombre d’incidents, leur durée, le nombre de collaborateurs touchés, le service affecté et la cause identifiée.
Deux indicateurs sont particulièrement utiles. Le temps moyen de résolution montre la rapidité du retour à la normale. Le taux de récurrence indique la proportion d’incidents qui reviennent après une première intervention. Une équipe peut ainsi constater qu’un incident résolu en dix minutes reste préoccupant s’il se répète chaque semaine auprès de vingt personnes.
À titre pratique, un responsable peut analyser les incidents des trente derniers jours et les classer par impact. Une panne qui bloque toute la facturation pendant une heure mérite une action prioritaire, même si elle est rare. À l’inverse, plusieurs demandes individuelles liées à un logiciel mal configuré peuvent justifier une procédure commune ou une formation courte.
Les contrôles à intégrer dans une routine fiable
Vérifier les sauvegardes, puis les restaurations
Une sauvegarde signalée comme réussie ne garantit pas que les fichiers pourront être récupérés. Il faut effectuer périodiquement une restauration de test sur un emplacement séparé et vérifier l’ouverture des documents. Le test doit couvrir les données les plus sensibles, avec une durée de conservation adaptée aux besoins de l’activité.
Une règle pratique consiste à définir à l’avance deux objectifs : la quantité maximale de données que l’entreprise accepte de perdre et le délai maximal souhaité pour remettre un service en fonctionnement. Ces objectifs orientent le choix des fréquences de sauvegarde, des supports et des procédures de reprise.
Planifier les mises à jour
Repousser systématiquement les mises à jour crée un écart entre les systèmes utilisés et les correctifs disponibles. À l’inverse, les installer sans préparation peut perturber un logiciel métier. La bonne approche consiste à inventorier les applications critiques, à tester les versions sur un périmètre limité et à prévoir une fenêtre d’intervention communiquée aux équipes.
Les postes qui ne peuvent pas être mis à jour immédiatement doivent être identifiés et faire l’objet d’un traitement spécifique. Cette visibilité permet de prioriser les remplacements ou les ajustements au lieu de découvrir la situation lors d’un incident.
Surveiller le réseau et les équipements
Les ralentissements réseau sont parfois attribués aux ordinateurs alors que leur origine se trouve dans un point d’accès saturé, un câble défectueux ou une mauvaise répartition des usages. Une surveillance élémentaire de la disponibilité, de la latence et de l’occupation des équipements aide à localiser le problème.
Les équipements réseau doivent aussi être inventoriés avec leur emplacement, leur rôle, leur version logicielle et leur date de remplacement prévisionnelle. Cette documentation accélère le diagnostic et limite les interventions à l’aveugle.
Les erreurs qui rendent la maintenance moins efficace
La première erreur consiste à attendre la panne complète pour agir. Les signes précurseurs sont souvent visibles : démarrages plus longs, déconnexions répétées, alertes de stockage, erreurs de synchronisation ou demandes identiques provenant de plusieurs utilisateurs. Les regrouper dans un suivi unique permet de traiter la cause avant qu’elle ne devienne bloquante.
Une autre erreur consiste à ne pas attribuer clairement les responsabilités. Les collaborateurs doivent savoir comment signaler un incident, quelles informations fournir et à quel moment une situation devient prioritaire. De son côté, la personne ou l’équipe chargée de la maintenance doit disposer d’un inventaire à jour et d’un accès encadré aux systèmes nécessaires.
Enfin, une intervention sans compte rendu fait perdre une partie de la valeur du travail réalisé. Chaque action significative devrait laisser une trace simple : problème observé, diagnostic, correction, résultat du test et éventuelle action préventive. Cette mémoire technique réduit le temps de résolution lors du prochain incident.
Construire un plan d’action applicable dès maintenant
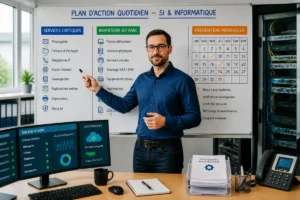
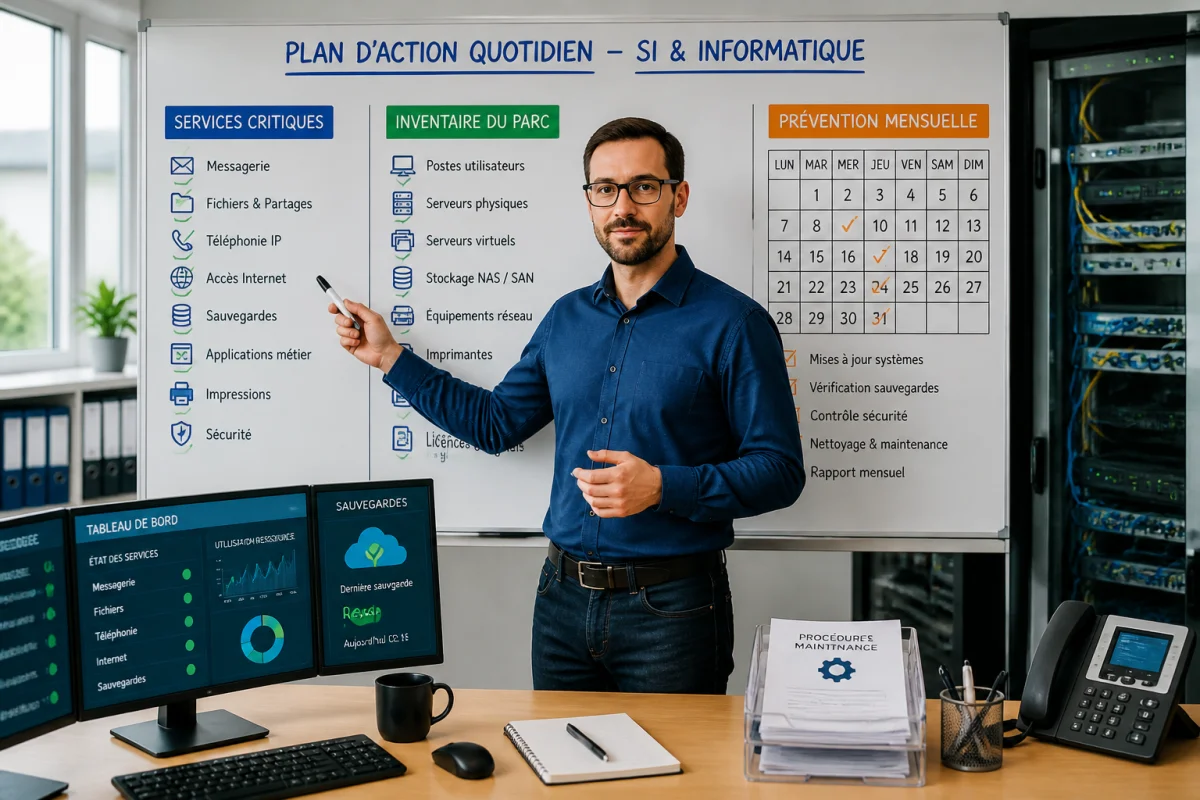
La première étape consiste à établir la liste des services indispensables à l’activité. Il peut s’agir de la messagerie, de l’accès aux fichiers, du logiciel de gestion commerciale, de la téléphonie ou de la connexion aux sites distants. Pour chaque service, il faut identifier les utilisateurs concernés, la personne responsable et la procédure de retour à la normale.
La deuxième étape est de réaliser un état du parc. Le document doit au minimum recenser les postes, les serveurs, les équipements réseau, les logiciels critiques et les solutions de sauvegarde. L’objectif n’est pas de produire un inventaire parfait en une journée, mais de disposer d’une base exploitable et de la mettre à jour après chaque changement.
La troisième étape est de réserver du temps à la prévention. Une demi-journée mensuelle consacrée aux alertes, aux sauvegardes et aux mises à jour peut révéler des problèmes restés invisibles. Les actions décidées doivent ensuite être classées selon leur impact sur la continuité de l’activité et non selon leur facilité d’exécution.
Enfin, il est utile de tester un scénario concret, par exemple l’indisponibilité d’un serveur de fichiers ou la perte d’un poste contenant des données de travail. L’exercice fait apparaître les informations manquantes, les dépendances entre services et les délais réels de rétablissement. Il transforme un plan théorique en procédure utilisable.
Faire de la maintenance un levier de continuité
Une maintenance informatique en entreprise efficace se reconnaît moins au nombre d’interventions qu’à la diminution des interruptions subies par les équipes. Elle repose sur un suivi régulier, des priorités explicites, des sauvegardes réellement testées et une documentation suffisamment claire pour accélérer chaque diagnostic.
Le meilleur point de départ est souvent très concret : analyser les incidents du dernier mois, choisir les trois causes les plus fréquentes et leur associer une action mesurable. Cette démarche crée rapidement une base de travail, donne de la visibilité aux collaborateurs et permet de consacrer davantage de temps aux activités essentielles de l’entreprise.